

Claude写代码太快,Anthropic决定重新设计Git
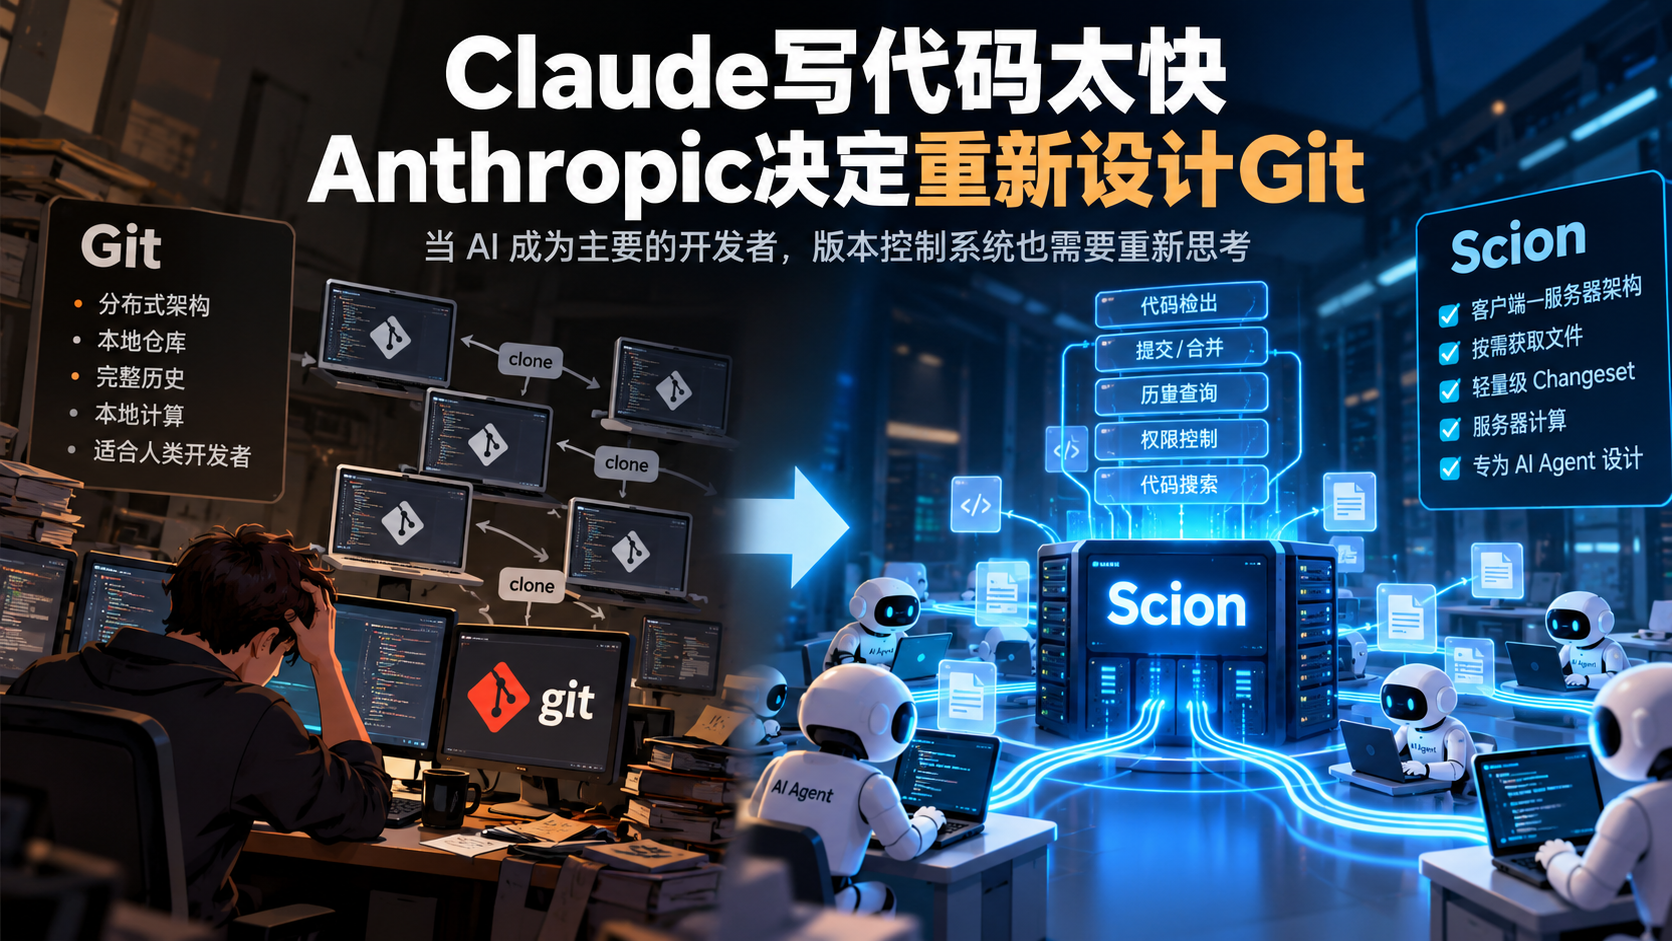
10月13日,Anthropic 发布了一篇技术文章《Redesigning source control at Anthropic》,介绍了他们如何在短短5个月内,开发出一套名为 Scion 的版本控制系统,并将内部大型代码仓库从 Git 迁移到 Scion。
为什么要重新开发一套版本控制系统?
原因很简单:Claude 写代码的速度太快,Git 已经跟不上了。
2026年5月,Anthropic 每天平均合并约2500次代码变更。到了9月,这个数字已经超过30000次,短短4个月增长了12倍。
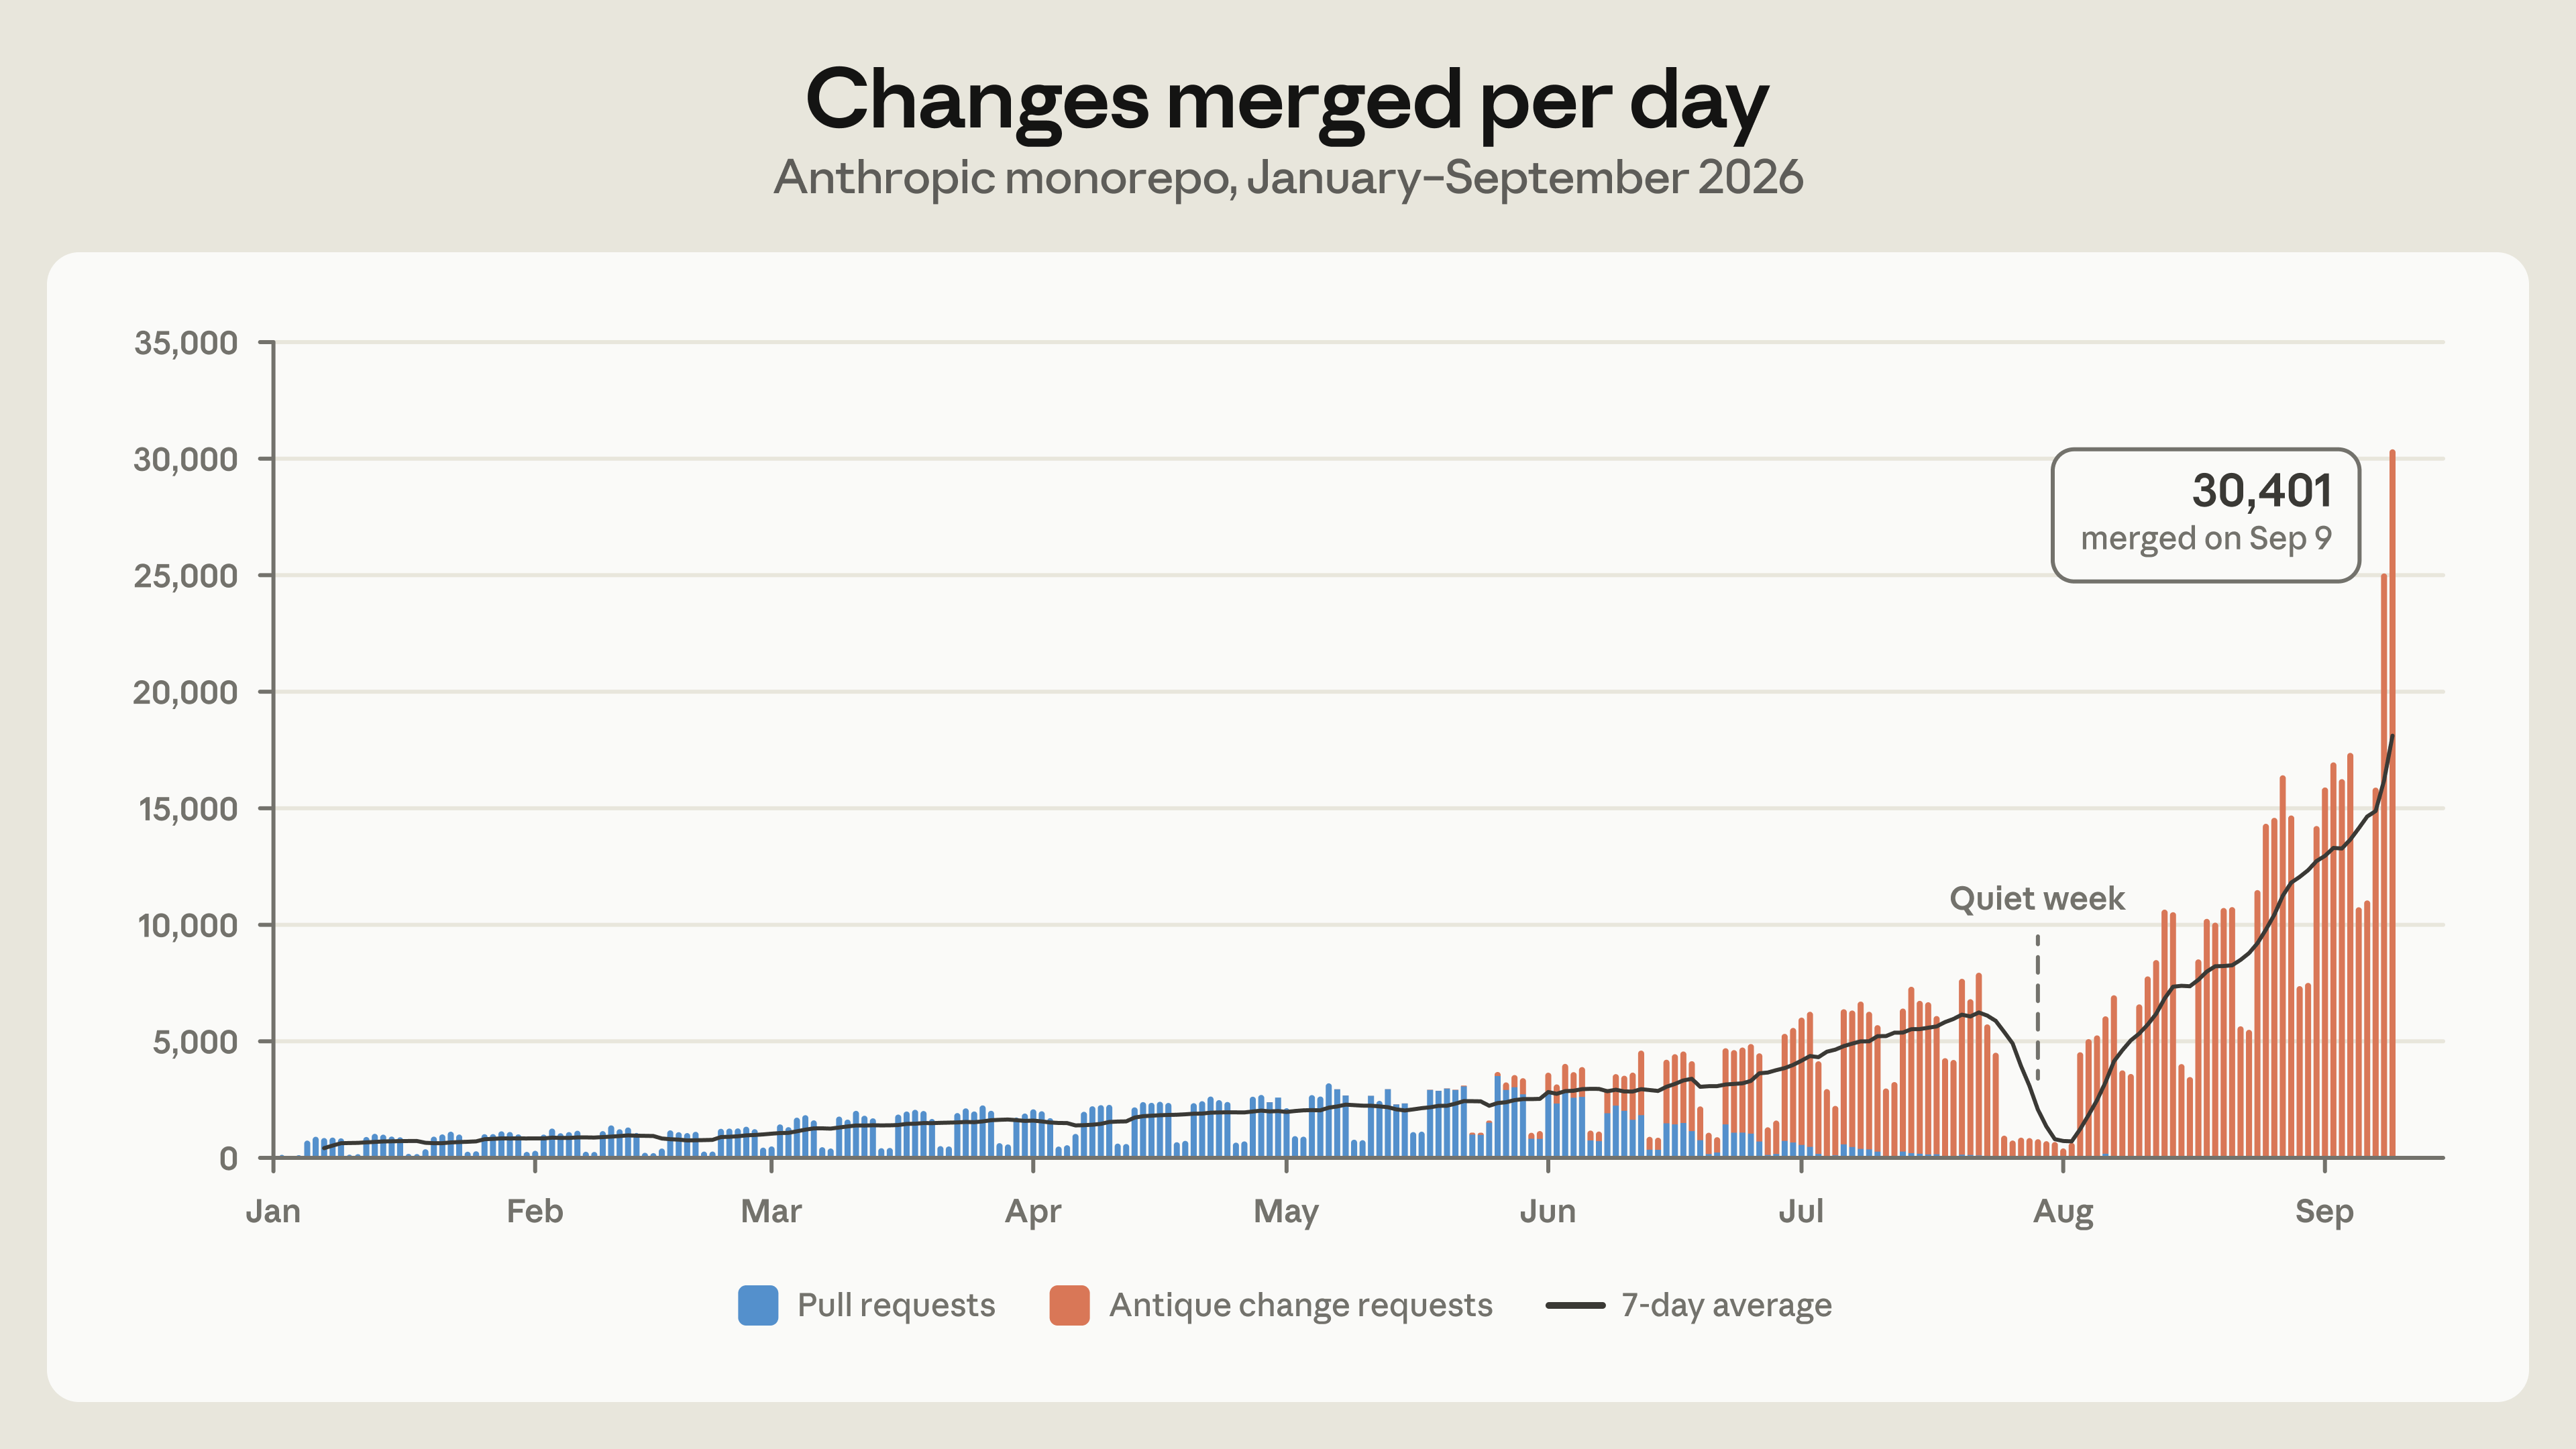
2026 年 1 月至 9 月,每天合并到我们 monorepo 的变更数量。
随着大量 AI Agent 参与开发,Anthropic 的主分支历史数据已经接近100GB,压缩后的工作副本也超过25GB。
更夸张的是,仅 CI 系统每天就需要执行约2500万次代码检出。如果按照传统方式获取 Git 数据,理论上的每日传输量将超过600PB。
尽管 Git 已经提供了浅克隆、稀疏检出等优化机制,Anthropic 甚至部署了数百个 Git 镜像服务器,但仍然难以应对这种增长速度。
于是,他们开始重新思考一个问题:
如果软件开发的主要执行者不再是人类,而是 AI Agent,我们还需要一套为人类开发者设计的版本控制系统吗?
一、从 Git 到 Scion,究竟改变了什么?
Git 诞生于2005年,它最重要的设计理念之一就是分布式。
每个开发者都可以在本地拥有一个独立的代码仓库,即使没有网络,也能查看历史、创建提交、切换分支。
这对于人类开发者非常有价值。
但 Anthropic 发现,AI Agent 的工作方式与人类有很大不同。
1. 从分布式架构变成客户端—服务器架构
Git 的设计假设是:每个开发者都应该拥有独立工作的能力。
因此,每个客户端都需要保存足够的仓库数据,并且具备执行 Commit、Merge、Rebase 等操作的能力。
Scion 则完全不同。
它的设计假设是:AI Agent 始终在线,可以随时访问服务器。
因此,Scion 将大部分版本控制操作转移到了服务器。
| 操作 | Git | Scion |
|---|---|---|
| 创建 Commit | 本地执行 | 服务器执行 |
| Merge | 通常本地执行 | 服务器执行 |
| Rebase | 通常本地执行 | 服务器执行 |
| 查询历史 | 本地仓库 | 服务器 API |
| 文件存储 | 本地保存仓库对象 | 按需获取并缓存 |
| 离线工作 | 支持 | 依赖在线服务 |
这样一来,Agent 不再需要维护一个功能完整的本地 Git 仓库。
它只需要通过 API 请求服务器完成相应操作。
Scion 实际上把版本控制从一个主要运行在开发者本地的工具,变成了一项集中提供的基础设施服务。
2. 从获取仓库,变成按需获取文件
假设一个 Agent 的任务只是修改 Java 项目中的一个 Controller。
对于 Git,即使使用浅克隆或稀疏检出等优化,客户端通常仍然需要处理一定的仓库元数据和对象同步。
而 Scion 从底层协议开始,就围绕按需获取数据设计。
Agent 需要哪个目录,就请求哪个目录。
需要哪个文件,就获取哪个文件。
甚至可以完全不下载文件。
例如,Agent 想知道某段代码是谁修改的,可以直接调用 Scion API 查询,而不需要准备本地仓库。
Scion 还支持虚拟化检出,只有真正读取文件时,才从服务器获取文件内容。
这种设计尤其适合 AI Agent。
因为 Agent 执行的大量任务,并不需要整个项目的代码和历史数据。
对于一个只需要修改三个文件的 Agent,没有必要让它承担整个仓库的存储和同步成本。
3. 从完整快照引用,变成轻量级 Changeset
这是 Scion 在底层数据结构上最重要的变化之一。
Git 使用 Commit 和 Tree 对象描述代码版本。每个 Commit 引用一棵代表仓库文件状态的目录树,未变化的对象可以在不同版本之间共享。
Scion 则使用一种叫作 Changeset 的数据结构。
它主要记录本次提交相对于第一个父节点修改了哪些文件,以及这些文件对应的内容地址。
例如:
Changeset #1001

修改:
  UserController.java
  UserService.java

新增:
  UserDTO.java
文件内容单独存储在对象存储系统中。
这样,创建一个 Changeset 的成本可以主要取决于本次修改的规模,而不是整个仓库的规模。
与此同时,Scion 为文件历史、Blame、Commit 关系等查询建立专门的索引结构。
需要注意,Git 本身也通过对象共享避免重复存储完整文件,因此 Scion 并不是简单地把 Git 的全量快照改成增量存储。
真正的区别在于,Scion 重新设计了提交、数据索引和存储协议,使它们更适合服务器端的高并发处理。
4. 从本地计算,变成多级缓存和横向扩展
Git 的分布式设计,让大量计算发生在客户端。
而 Scion 把这些计算集中到服务器后,又面临一个新问题:
如果几千个 Agent 同时请求服务器,服务器岂不是更容易成为瓶颈?
Anthropic 的解决方案是多级缓存和横向扩展。
Scion 大致采用以下架构:
        AI Agent / CI
              │
              ▼
         Scion Client
              │
              ▼
         scion-daemon
          节点级缓存
              │
              ▼
         scion-cache
          区域级缓存
              │
              ▼
         scion-server
          版本控制服务
              │
       ┌──────┴──────┐
       ▼             ▼
     Spanner      对象存储
由于 Scion 使用内容寻址存储,文件对象一旦写入就不会改变,因此可以被不同层级的服务器安全缓存。
这让它能够通过增加服务器节点来提高并发处理能力,而不需要每台服务器都保存一份完整的仓库。
Anthropic 公布的效果相当惊人:
- 各级缓存命中率超过99%。
- 版本控制基础设施的 CPU 和内存资源占用降低约200倍。
- CI 和研究任务的代码检出速度提高约100倍,从分钟级缩短到秒级。
- CI 系统节省约25%的 CPU 容量。
这些数字并不是说 Scion 的所有操作都比 Git 快100倍,而是 Anthropic 在其特定工作负载下取得的实际效果。
二、为什么 AI Agent 需要一套不同的版本控制系统?
把前面的改变放在一起,就能发现 Scion 的设计思路其实非常清晰。
它不是简单地优化 Git 的性能,而是重新审视 Git 的设计前提。
Git 主要围绕人类开发者设计:
人类可能离线工作,需要本地独立提交代码;人类通常以相对有限的频率修改代码;人类还需要方便地查看和操作版本历史。
但 AI Agent 的特点恰恰不同:
它们通常始终在线,可以直接调用 API;它们能够大规模并发执行任务;它们经常只需要访问少量文件;它们还可能在短时间内产生远超人类的代码变更。
因此,Git 的一些优势,在 Anthropic 的场景下反而变成了额外成本。
例如,Git 允许每个客户端独立完成版本控制操作,这对于离线开发很重要。
但如果数千个 Agent 都在数据中心运行,始终连接着服务器,那么让每个 Agent 维护本地版本控制能力,可能就没有那么大的必要。
再比如,Git 的设计允许客户端自行计算大量仓库信息。
但如果数千个 Agent 都在重复查询同一段代码的历史,集中计算一次并通过缓存共享结果,显然可能更加高效。
这就是 Scion 的核心逻辑:
不再追求让每个客户端都拥有完整能力,而是通过集中服务,让大量轻量级客户端高效协作。
当然,这并不意味着集中式架构天然优于分布式架构。
只是当工作负载发生根本变化时,原本合理的架构选择也可能需要改变。
三、Scion 会不会带来新的问题?
Scion 解决了 Anthropic 的性能瓶颈,但这种架构并不是没有代价。
首先是对服务器和网络的依赖。
Git 的重要优势是,即使远程服务器发生故障,开发者依然可以在本地提交代码、查看历史和继续工作。
而 Scion 将 Commit、Merge、Rebase 等核心操作集中到了服务器。
这意味着服务器的可用性、网络延迟和故障恢复能力变得更加重要。
一旦中心服务出现大范围故障,可能影响大量 Agent 的工作。
其次是集中式系统的复杂性。
Scion 虽然简化了客户端,但服务器端需要处理高并发提交、数据一致性、缓存管理、权限控制和故障隔离等问题。
尤其是当大量 Agent 同时修改代码时,如何高效处理冲突、维护代码质量,依然是一个复杂的工程问题。
事实上,Anthropic 已经发现,传统的 Merge Queue 很难适应如此高的代码合并速度。
他们开始更多采用合并后测试和部署前测试,而不是完全依赖合并前的串行验证。
这种方式能够提高吞吐量,但也可能让存在问题的代码更早进入主分支,对自动检测、修复和部署隔离能力提出更高要求。
最后是生态兼容性问题。
Git 已经拥有非常成熟的工具生态,包括代码托管、审查、搜索、CI/CD 等。
而 Scion 与 Git 的架构差异很大,Anthropic 不得不同时开发新的代码审查系统 Antique,以及配套的代码搜索和权限管理系统。
因此,Scion 并不是一个可以直接替换 Git 的通用工具。
Anthropic 自己也明确表示,它主要适合拥有超大型 Monorepo、海量并发开发任务的特殊场景。
对于绝大多数软件开发团队,Git 仍然是更加合理的选择。
四、最后
这篇文章中还有一个很有意思的细节。
Anthropic 只用了7名工程师,就在5个月内完成了 Scion、Antique 及多项配套系统的开发和迁移。
而帮助他们完成这项工作的,恰恰也是 Claude。
也就是说,Claude 的编程能力提升导致 Git 成为瓶颈,而 Anthropic 又利用 Claude 开发出新的版本控制系统,解决了这个瓶颈。
这形成了一个有趣的循环:
AI 编程能力提升 → 现有基础设施出现瓶颈 → 利用 AI 重构基础设施 → AI 编程能力得到进一步释放。
Scion 只是这个循环中的一个案例。
未来,随着 AI Agent 越来越多地参与软件开发,代码审查、测试、构建、部署等基础设施,也可能经历类似的变化。
而这篇文章真正值得思考的问题或许是:
当软件开发的主要执行者逐渐从人类转向 AI Agent,我们究竟应该让 AI 继续适应人类设计的工具,还是应该开始为 AI 重新设计工具?
Scion 给出了 Anthropic 的答案。
0条留言