

Yann LeCun终于把LLM打趴下了吗?
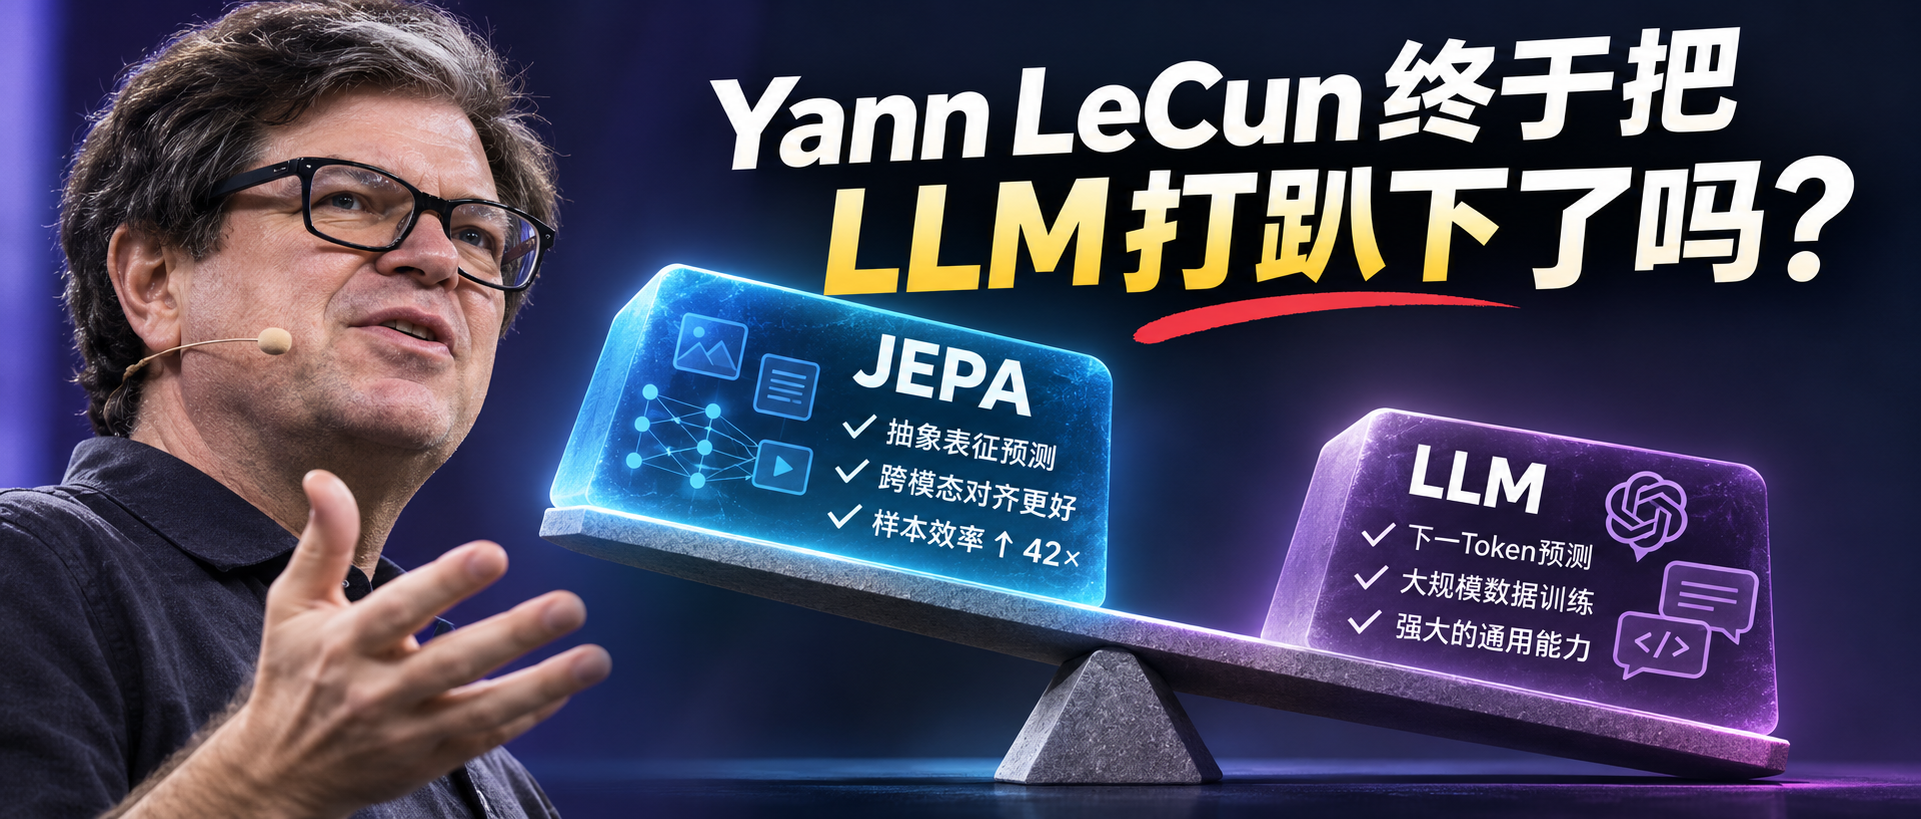
长期以来,图灵奖得主、深度学习三巨头之一的 Yann LeCun 一直是大语言模型(LLM)路线的坚定批评者。
他并不否认 ChatGPT 等大语言模型取得的成功,但始终认为,仅仅依靠预测下一个 Token,难以让 AI 真正理解世界,更难以实现人类水平的智能。
相比之下,他更推崇 JEPA(联合嵌入预测架构),主张让 AI 学习世界的抽象表征,而不是执着于预测每一个具体细节。
但问题是,过去几年,LLM 在不断进步,而 JEPA 始终缺少足够有说服力的成果。
直到最近,一篇由 Yann LeCun 和 Randall Balestriero 共同署名的新论文《Proving and Improving the Platonic Representation Hypothesis with JEPAs》引起了关注。
论文给出了一个令人意外的实验结果:
一个仅有 1.09 亿参数的 JEPA 模型,在跨模态表征对齐任务中,超过了拥有 720 亿参数的 Qwen2.5。
这是否意味着 LeCun 坚持多年的路线终于获得验证,LLM 即将被 JEPA 取代?
事情没有这么简单。
JEPA 和 LLM,究竟有什么不同?
要理解这篇论文,首先要弄清楚双方到底在争论什么。
当前主流 LLM 的核心训练方式是下一 Token 预测。
例如,给模型输入:
“苹果从树上掉下来,是因为……”
模型需要预测后面可能出现的文字,比如“重力”。
通过学习海量文本中的统计关系,模型逐渐掌握语言、知识、推理模式,甚至表现出一定的世界理解能力。
但 LeCun 认为,这种学习方式存在根本性的效率问题。
LLM 学习的是如何预测文字,而理解世界只是为了完成文字预测而间接获得的能力。
JEPA 则采用另一种思路。
假设我们有一张猫躺在沙发上的照片,同时有两段描述:
A:“一只橘猫躺在灰色沙发上。”
B:“沙发上有一只正在休息的猫。”
虽然两段文字不同,但它们描述的是同一个场景。
JEPA 希望模型学习这些不同观测背后的共同信息,而不必精确预测每个词或每个像素。
简单来说:
- LLM:通过预测数据,间接学习世界。
- JEPA:通过预测抽象表征,学习不同观测之间的共同结构。
当然,两者并不是完全对立的技术。
JEPA 是一种训练架构和学习目标,可以使用 Transformer 实现;LLM 则通常指以语言建模为核心的大规模生成模型。
真正的争议不是 Transformer 和 JEPA 谁更先进,而是哪一种训练目标更有利于 AI 建立对世界的理解。
这篇论文究竟证明了什么?
论文围绕一个重要的理论展开:柏拉图表征假说(Platonic Representation Hypothesis)。
这个假说认为,不同 AI 模型即使通过不同模态学习世界,最终也可能形成相似的内部表征。
例如,人可以通过看到猫、听见猫叫、阅读猫的文字描述来认识猫。
虽然信息来源不同,但我们最终理解的是同一个现实对象。
那么,AI 是否也能做到这一点?
论文首先在特定数学假设下证明:如果不同模态的模型能够从同一潜在世界状态中获取满足条件的观测,并完成相应的 JEPA 训练,它们学习到的表征可以在旋转变换意义下对齐。
更值得关注的是实验结果。
在论文采用的跨模态表征对齐指标上:
| 模型 | 参数规模 | 对齐得分 |
|---|---|---|
| 文本 JEPA | 1.09 亿 | 0.184 |
| Qwen2.5 | 720 亿 | 0.154 |
| Llama 3 | 700 亿 | 0.151 |
不仅如此,论文还报告,采用合适观测视图训练的 JEPA,在达到相近表征对齐水平时,样本效率可提高约 42 倍。
这两个结果相当有吸引力。
因为它们暗示:模型规模可能不是决定世界表征质量的唯一关键因素,训练目标本身同样重要。
如果能够设计更合理的学习任务,小模型也可能在某些表征能力上超过远大于自己的模型。
不过,这里存在一个必须强调的事实:
论文比较的是跨模态表征对齐能力,而不是通用智能水平。
JEPA 在这个指标上超过 Qwen,并不意味着它的语言理解、数学推理、代码编写能力也超过 Qwen。
更不能因此断言,一个 1 亿参数的 JEPA 已经具备了 700 亿参数 LLM 的全部能力。
JEPA 是否真的比 LLM 更高效?
尽管论文的实验结果令人兴奋,但要判断 JEPA 是否真的比 LLM 更高效,还有两个问题不能忽略。
第一个问题:JEPA 的训练数据从哪里来?
LLM 最大的优势之一,就是训练数据极其容易获取。
互联网上的网页、书籍、代码,只要经过适当处理,都可以成为下一 Token 预测的训练材料。
JEPA 则需要构造能够反映同一潜在状态的不同观测,也就是论文所说的 Good Views。
这并不容易。
例如,如何确保两段不同的文字描述,确实对应同一个世界状态,而不是仅仅在语义上相似?
值得注意的是,这篇论文的一部分训练数据,实际上使用了 LLaVA 这样的视觉语言模型生成额外的图片描述。
这就带来了一个有趣的问题:
如果 JEPA 的训练需要借助已经训练好的大型视觉语言模型,那么究竟是谁提供了那些高质量的世界知识?
这当然不能否定 JEPA 的实验结果,但意味着我们不能只比较最终模型的参数数量,还需要考虑整个数据生产和训练流程的成本。
第二个问题:42 倍效率是否意味着训练成本降低 42 倍?
答案是否定的。
样本效率不等于计算效率。
不同训练方式对样本的定义可能不同,模型结构、计算量、训练配置也会影响最终成本。
因此,42 倍是论文特定实验条件下的样本效率结果,并不代表 JEPA 训练一个通用模型的成本只有 LLM 的四十二分之一。
更何况,JEPA 目前还没有像主流 LLM 那样,在大规模通用生成与推理任务中获得充分验证。
所以,我认为目前更合理的结论是:
JEPA 在特定表征学习任务上展现了显著的效率优势,但还没有证明这种优势能够直接转化为通用智能能力和整体训练成本优势。
这两者之间,还有相当大的研究空间。
JEPA 是否真的比 LLM 更有前途?
这个问题需要区分两个层面。
首先,如果我们的目标是构建一个能够流畅交流、回答问题、编写程序的 AI,那么 LLM 显然仍然占据优势。
经过多年发展,下一 Token 预测已经证明了极强的扩展能力。
海量数据可以直接用于训练,模型规模扩大后,语言、知识与推理能力也不断提高。
这些都是 JEPA 目前尚未全面展示的成果。
但如果目标是构建一个真正理解物理世界、能够预测环境变化并自主采取行动的 AI,情况就不同了。
现实世界不是一串文字。
机器人需要理解空间、物体、运动、因果关系,还需要在不确定环境中预测行动的后果。
对于这类任务,精确预测每个像素或者每个词,未必是最高效的学习方式。
JEPA 试图保留那些对理解和预测世界有用的信息,忽略无关的表面细节。
这条路线具有明确的研究价值。
不过,JEPA 同样面临一些尚未解决的关键问题:能否像 LLM 一样,直接利用互联网海量非结构化数据进行大规模自监督训练?能否在模型规模扩大后,持续提升知识理解与泛化能力?它所学习的抽象表征,能否有效支持复杂推理、语言生成等更广泛的智能任务?
更重要的是,JEPA 在特定任务上的效率优势,能否随着模型规模扩大,转化为通用能力上的优势?
这些问题尚未得到充分验证,也是 JEPA 距离成为一条成熟的通用 AI 技术路线仍需跨越的障碍。
事实上,JEPA 和 LLM 也未必是非此即彼的关系。
未来完全可能出现一种混合架构:
由 JEPA 负责学习跨模态的世界表征,由动态世界模型负责预测和规划,再由语言生成模型负责人机交互与知识表达。
在这种架构中,双方不是竞争关系,而是承担不同的功能。
真正值得关注的,不是谁打败了谁
我认为,这篇论文最重要的价值,并不是那个令人兴奋的“1 亿参数超过 720 亿参数”。
而是它向当前 AI 研究提出了一个值得重新审视的问题:
我们是否过度关注模型规模,却低估了训练目标对智能形成的影响?
过去几年,大模型的发展主要围绕更多的数据、更大的模型和更多的计算资源展开。
这条路线取得了不可否认的成功,但并不意味着它已经是最优解。
JEPA 的实验至少说明,在某些任务中,通过改变学习目标,可以获得单纯扩大模型规模难以实现的效率优势。
但同样需要警惕另一个极端:因为 JEPA 在一个指标上取得突破,就认定 LLM 已经走进死胡同。
目前还没有足够的证据支持这样的结论。
LLM 已经证明了自己的通用能力,但不代表下一 Token 预测就是智能的最终答案。
JEPA 展现了另一种学习世界的可能性,但距离证明自己能够实现通用智能,还有很长的路要走。
对于未来的 AGI,真正关键的可能不是模型能否生成更自然的语言,而是它能否建立稳定的世界模型、积累长期记忆,并在与环境的持续交互中不断更新自己的认知。
这些挑战并不只属于 JEPA 或 LLM,而是所有试图实现通用智能的技术路线都必须面对的问题。
谁能够更好地解决这些问题,谁才更有可能成为下一阶段 AI 技术的核心。
0条留言