

Jev 让 AI 不止会生成,也应该会做决定
最近出来一个挺有意思的新模型:Jev。
它和我们平时使用的 GPT、Claude、DeepSeek、Qwen 这些 LLM 有一个很大的区别:
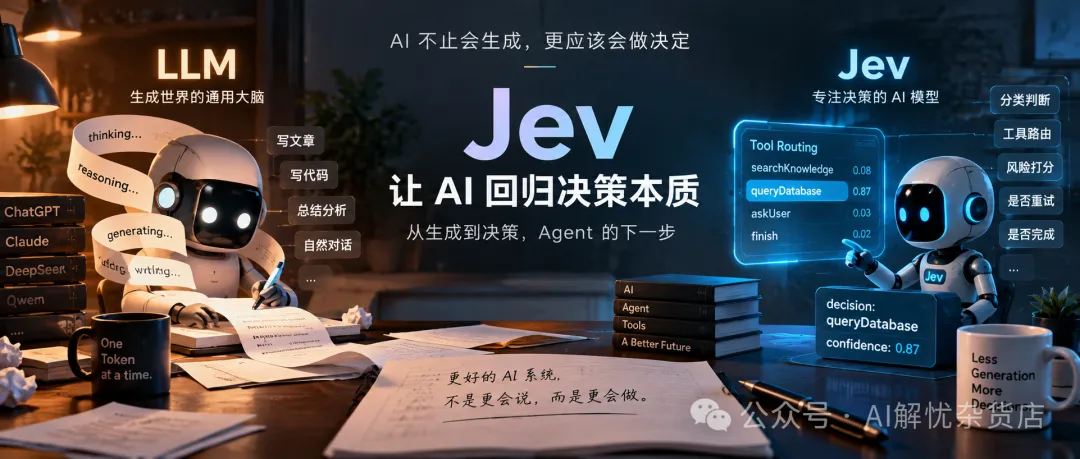
LLM 的核心能力是生成,而 Jev 的核心能力是决策。
这看起来只是输出形式不同,但实际上背后的思路很值得关注,特别是在 Agent 越来越普及以后。
LLM 为什么需要一个 Token 一个 Token 地生成?
我们现在使用的主流 LLM,基本都是自回归生成模型。
比如问模型:
这个用户的问题应该交给哪个工具处理?
A. 搜索知识库
B. 查询数据库
C. 询问用户
D. 直接回答
LLM 的处理过程大致是:
   输入
 ↓
Transformer
 ↓
预测第一个 Token
 ↓
预测第二个 Token
 ↓
预测第三个 Token
 ↓
……
 ↓
完整答案
哪怕最终我们只需要模型回答:
B
或者要求它返回结构化数据:
   {
  "tool": "queryDatabase"
}
底层本质上依然是在做 Token Generation。
也就是说,LLM 必须先把答案“写出来”,我们的程序再去读取这个答案。
这对于聊天、写文章、写代码当然非常合理。
但问题在于,现在很多地方使用 LLM,实际上根本不需要它生成内容。
特别是在 Agent 中。
Agent 中其实存在大量「不需要生成」的 LLM 调用
现在一个典型的 Agent 工作流程可能是:
   用户提出问题
 ↓
LLM 理解问题
 ↓
制定计划
 ↓
选择 Tool
 ↓
执行 Tool
 ↓
判断 Tool 结果
 ↓
决定继续执行还是结束
 ↓
LLM 生成最终答案
这里真正需要“生成能力”的,其实只有一部分。
比如:
-
• 理解复杂需求 -
• 制定执行计划 -
• 写代码 -
• 总结资料 -
• 生成最终回答
但还有大量操作,本质上只是做判断:
应该调用哪个 Tool?
Tool 执行成功了吗?
当前结果是否已经足够?
是否应该 Retry?
任务是否已经完成?
是否需要人工审批?
这些问题最后需要的答案可能只是:
true / false
或者:
A / B / C / D
但现在我们依然经常调用一个几十亿甚至几百亿参数的 LLM,让它完成一次完整的生成过程。
从这个角度看,其实挺浪费的。
Jev 的思路:不要生成答案,直接做决定
Jev 做的事情就是把这类问题单独拿出来。
它不是:
   输入
 ↓
模型
 ↓
Token
 ↓
Token
 ↓
Token
 ↓
……
 ↓
答案
而更接近:
   输入
 ↓
模型
 ↓
Decision
 ↓
结果 + 概率
例如:
   应该调用哪个 Tool?

searchKnowledge   0.08
queryDatabase     0.87
askUser           0.03
finish            0.02
模型直接对预先定义好的结果空间进行判断。
最终得到:
   queryDatabase
confidence = 0.87
这也是 Jev 所属的这类模型被称为 System One Model 的原因之一。
它的目标不是替代 LLM 的生成能力,而是专门解决:
给定一个问题和有限的结果空间,让模型快速做出判断。
Jev 和 LLM 的核心区别
简单来说:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
所以 Jev 并不是:
一个比 GPT、DeepSeek、Qwen 更先进的新 LLM。
实际上它根本不是在和这些模型解决同一个问题。
更准确地说,是把过去全部交给 LLM 的工作拆成了两部分:
   AI System
 │
 ├─ Generative Model
 │      ↓
 │     LLM
 │      ↓
 │   生成 / 推理 / 编程 / 总结
 │
 └─ Decision Model
        ↓
       Jev
        ↓
     分类 / 路由 / 判断 / 打分
为什么这种模型可能特别适合 Agent?
我觉得 Jev 最值得关注的地方其实不是聊天,而是 Agent。
过去的 Agent 很大程度上建立在一个假设上:
既然 LLM 什么都能做,那就全部交给 LLM。
所以我们会让同一个模型:
   理解用户需求
↓
制定 Plan
↓
选择 Tool
↓
判断 Tool Result
↓
决定 Retry
↓
判断任务是否完成
↓
生成最终答案
但这里实际上混合了两种完全不同的工作。
第一种是开放式问题:
根据这些资料帮我分析问题并制定一个执行方案。
这种问题不存在有限的标准答案,需要真正的生成和推理能力。
LLM 非常适合。
第二种则是封闭式问题:
下一步应该调用哪个工具?
答案可能只有:
   knowledgeSearch
databaseQuery
webSearch
askUser
finish
这种情况下,我们真正需要的不是“生成”,而是“选择”。
于是未来的 Agent Runtime 可能会变成:
                    Agent
                   │
          ┌────────┴────────┐
          │                 │
         LLM               Jev
          │                 │
     复杂理解与生成       快速决策
          │                 │
     Plan / Code        Tool Routing
     Summary            Retry
     Answer             Finish
                        Classification
                        Scoring
这样 LLM 不需要负责 Agent Loop 中的每一个细小判断。
只有真正需要复杂推理和生成的时候,才调用 LLM。
其余大量控制流交给专门的 Decision Model。
如果这种架构最终证明有效,我觉得它对 Agent 的意义可能比对普通聊天机器人大得多。
Structured Output 其实还是不一样
看到这里可能会想到:
现在 LLM 已经可以 Structured Output 了。
例如直接要求:
   {
  "tool": "databaseQuery",
  "retry": false
}
是不是已经解决这个问题了?
其实没有。
Structured Output 主要解决的是:
限制 LLM 生成什么。
但底层通常仍然是:
   LLM
 ↓
Token Generation
 ↓
JSON Token
 ↓
JSON Token
 ↓
……
 ↓
完整 JSON
而 Jev 想解决的是:
为什么一定要生成?
如果最终程序需要的只是一个枚举:
databaseQuery
那么模型直接判断它属于哪个选项即可。
这两者解决的是不同层面的问题。
Jev 目前的使用现状
不过 Jev 现在还非常早期。
目前官方并没有公布完整的模型内部架构,也没有公开具体参数量。
模型权重同样没有开源,所以现在还不能像 Qwen、DeepSeek 这些开源模型一样直接下载到本地部署。
目前主要还是通过 API 使用。
官方公布的响应延迟大约在 70~500ms,并强调其成本和延迟相比传统生成式 LLM 有明显优势。不过 Jev 刚刚发布,这些性能数据目前更多还是官方数据,需要等待更多第三方测试。
另外,社区已经出现了一些类似思路的开源复现。
例如 NanoJev 使用大约 0.6B 参数尝试复现这种 Decision Model 思路,也有人基于 Gemma 等现有开源模型尝试实现不进行完整自回归生成的 Option Scoring。
这些项目并不是 Jev 本身,但至少说明:
这种思路并不一定需要一个几十 B 的大模型才能实现。
如果未来能够用一个很小的模型完成 Agent 内部大量 Routing、Classification、Retry、Finish、Scoring 等判断,再把昂贵的大模型留给真正需要复杂推理和生成的地方,那么 Agent 的延迟和运行成本可能都会有明显改善。
所以现阶段我觉得 Jev 最值得关注的并不是:
它能不能取代 LLM?
而是另一个问题:
我们现在是不是把太多原本只需要“做决定”的工作,也交给 LLM 去“生成答案”了?
如果答案是肯定的,那么 Jev 代表的这类 Decision Model,可能会成为未来 Agent 架构中一个很有意思的组件。
如果觉得内容不错,欢迎你点一下「在看」,或是将文章分享给其他有需要的人^^
相关好文推荐:
0条留言