

复制一个Jev可能比想象中简单
前段时间,我写过一篇关于 Jev 的文章,Jev 让 AI 不止会生成,也应该会做决定。
当时最让我感兴趣的,并不是 Jev 在某几个 Benchmark 上超过了多少模型,而是它提出的一个非常简单,却又很容易被忽略的问题:
生成和决策,真的是同一件事吗?
现在的大模型,本质上是一台非常强大的生成机器。
但 Agent 每天做的大量工作,其实不是生成,而是选择:要不要调用工具?调用哪个工具?这个任务应该交给哪个 Agent?这是正常请求还是高风险请求?用户属于哪一种意图?
如果答案只能从几个确定选项里选择一个,那么让一个大模型先生成几十个 Token,再把生成结果解析回来,本身就是一件有点奇怪的事情。
Jev 给出的答案是 Decision Model。
这些内容上一篇已经讲过,所以这篇不准备再重复。
因为最近发生了一件我觉得更有意思的事情。
Cloudflare 也做了一个 Jev。
它叫 Clef。
而且从 Cloudflare 公布的结果来看,他们不但做出来了,在大量任务上甚至比 Jev 做得更好。
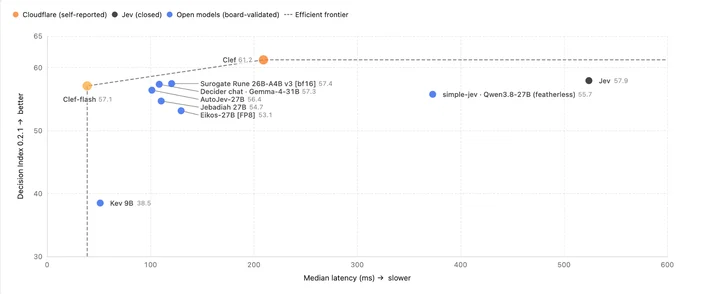
图:Cloudflare 对 Decision Model 的质量与延迟对比。来源:Cloudflare Blog
复制一个Jev可能比想象中简单
Cloudflare 这次发布了两个模型:
Clef 和 Clef-flash。
它们已经部署在 Workers AI,同时以 Apache 2.0 协议开源,并且兼容 Jev API。
Cloudflare 测试了 43 个 Benchmark,其中包括 BFCL、ToolRet、API-Bank、When2Call、BANKING77、CLINC150 等大量 Tool Calling、Routing 和 Classification 任务。
从结果来看,Clef 并不是所有测试都第一。
但一个很明显的事实是:
它已经处在和 Jev 同一个级别,而且很多指标超过了 Jev。
例如 BFCL:
| 模型 | 成绩 |
|---|---|
| Clef | 98.47 |
| Clef-flash | 98.76 |
| Jev | 95.75 |
API-Bank:
| 模型 | 成绩 |
|---|---|
| Clef | 91.93 |
| Clef-flash | 93.11 |
| Jev | 88.19 |
当然,也有 Jev 更好的项目,例如 When2Call 和 BRIGHT。
所以这里并不能得出“Clef 全面超过 Jev”的结论。
但这件事情本身已经足够有趣:
Jev 并没有形成一道无法复制的技术壁垒。
更关键的是,Cloudflare 这次不只是把模型发布出来了。
他们甚至把“我是怎么做出来的”讲得相当清楚。
原文:Introducing Clef: our open-source decision models, and new RL fine-tuning platform
Cloudflare 并没有从头训练一个模型
这是整件事情里我觉得最值得注意的地方。
第一次看到 Jev 时,很容易产生一种感觉:
Decision Model 是不是需要设计一种完全不同于 LLM 的模型?
是不是需要重新预训练?
是不是需要巨大的训练数据和算力?
Cloudflare 给出的答案至少说明:
未必。
Clef 的 Backbone 直接来自现成的大模型。
Cloudflare 使用:
- Qwen3.8-27B → Clef
- Qwen3.5-9B → Clef-flash
也就是说,他们并没有从零开始训练一个“决策基础模型”。
而是拿一个已经训练好的 LLM,然后进行改造。
这一下就把问题从:
怎么训练一个新的基础模型?
变成了:
怎么把一个现成的 LLM 改造成 Decision Model?
这两个问题的难度完全不是一个量级。
真正需要改造的,是模型的“出口”
普通 LLM 干一件事情的方式大家已经非常熟悉:
Context
   ↓
Transformer
   ↓
生成 Token
   ↓
生成下一个 Token
   ↓
再生成下一个 Token
   ↓
最终得到答案
但 Decision Model 根本不需要这个过程。
假设 Agent 现在只有四个动作:
search_web
query_database
read_file
answer_user
我们真正想知道的其实只有:
search_web       0.03
query_database   0.08
read_file        0.87
answer_user      0.02
既然如此,为什么还要让模型一个 Token 一个 Token 地生成:
{"tool":"read_file"}
Cloudflare 干了一件很直接的事情:
保留 LLM 强大的 Context Understanding 能力,但是把 autoregressive generation 这套输出方式换掉。
模型先利用 Qwen 做 prefill-only pass,然后直接对 Schema 中允许的候选项并行评分。
Decision Step 本身是:
Non-autoregressive。
换句话说:
Qwen 负责“看懂问题”,Clef 新增加的部分负责“做选择”。
这可能是整个 Clef 最重要的设计。
图:Decision Model 不需要自由生成答案,而是针对预先定义的问题和候选项并行给出概率。来源:Cloudflare Blog
Qwen 本体甚至不用重新训练
Cloudflare 的训练方法进一步降低了这件事情的神秘感。
他们冻结了 Qwen3.8-27B 和 Qwen3.5-9B Backbone,然后联合优化:
Routing Head + rank-256 Low-rank Adapters。
当然,真正实现 Clef 绝不是简单挂一个 LoRA 就结束了。
Cloudflare 还设计了两阶段 Attention Routing,让每个合法候选项从 Context 中提取与自己相关的信息;不同字段之间可以 Cross-Attention,最后再进行 Schema-bound Scoring。
训练中还使用了:
- Label-smoothed cross-entropy
- Brier loss
- 内部合成数据
- RLCD(Reinforcement Learning for Calibrated Decisions)
所以,如果说“随便拿 Qwen 挂个 LoRA 就能复制 Jev”,显然是在夸大。
但另一面也同样重要:
这里没有重新预训练一个基础模型。
真正昂贵的世界知识、语言理解、代码理解、视觉理解等能力,Qwen 已经替你训练好了。
你需要解决的,是如何把这些能力重新映射成一个:
Context → Decision Probability
的系统。
这和重新造一个 LLM 已经完全不是一回事了。
Benchmark 之外,速度更能说明问题
Cloudflare 给出的延迟数据也很有意思。
| 模型 | Median Latency |
|---|---|
| Clef | 209.3 ms |
| Clef-flash | 38.8 ms |
| Jev | 524.1 ms |
| DiffusionGemma Jev | 84.4 ms |
| Kev-9B | 51.4 ms |
| Laya | 5.8 ms |
其中 Clef-flash 的 Median Latency 只有 38.8ms,Jev 则是 524.1ms。
当然,不同模型、不同硬件和不同实现之间的延迟不能简单等同。
但这里至少说明了一件事情:
当模型不再需要 autoregressive generation 后,Decision Model 的速度可以非常夸张。
因为它不需要:
Token → Token → Token → Token → Token
而是:
Context
   ↓
Prefill
   ↓
Decision Head
   ↓
概率
这就让 Decision Model 有机会真正进入 Agent 的 Hot Path。
一次 Agent 任务可以调用它几十次。
Jev 真正的护城河不是 Jev
Jev 最重要的贡献,不是训练出了一个别人无法复制的模型。
而是它让大家意识到:
决策模型值得单独存在。
一旦这个问题被提出,后面的事情就开始变得工程化。
找一个足够强的开源 Backbone。
冻结大部分参数。
设计 Decision Head。
设计 Schema 表达。
构造决策训练数据。
做 LoRA。
做概率校准。
再用 RL 优化。
最后针对推理框架优化 Prefill 和候选项并行评分。
这仍然是一项相当复杂的模型工程。
但它已经不再像训练 GPT、Claude、DeepSeek 那样,是一场只有少数基础模型公司才能参加的游戏。
一家有不错模型团队的公司,甚至一个足够强的开源团队,都有机会做。
所以,接下来可能会出现很多个“Jev”。
Clef 最值得关注的不是它能不能打败 Jev,而是:
它证明 Jev 可以被复制。
而一旦第二个人成功了,第三个、第四个通常就不会太远。
尤其现在我们已经有 Qwen、Llama、Gemma、Mistral 等大量成熟的开源 Backbone。
Decision Model 需要解决的,不再是“让模型理解世界”。
基础模型已经完成了最昂贵的那部分工作。
后来者真正需要解决的是:
如何把这种理解能力转换成稳定、快速、可校准的决策能力。
这意味着未来我们很可能看到越来越多:
Tool Decision Model、Router Model、Safety Decision Model、Computer Use Decision Model、Enterprise Workflow Decision Model……
甚至不同企业完全可以针对自己的业务数据,训练自己的 Decision Model。
Cloudflare 自己也正在往这个方向走。
他们这次同时推出 RL Fine-tuning 基础设施,希望利用真实生产数据不断训练专用 Decision Model。
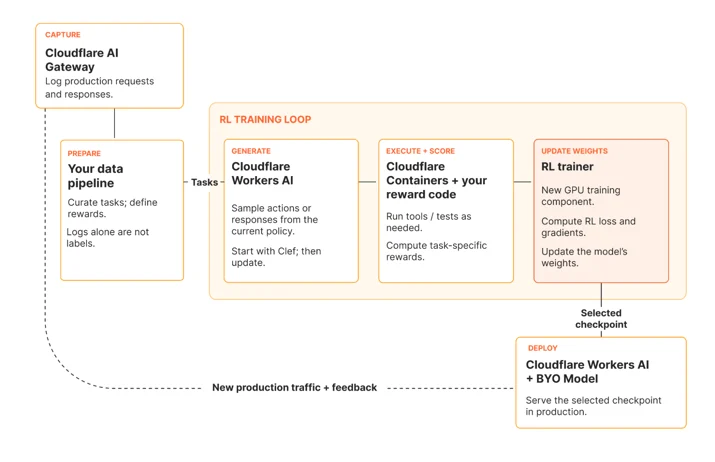
图:Cloudflare RL Fine-tuning 平台架构。来源:Cloudflare Blog
这套流程把 AI Gateway → 数据 → Rollout → Sandbox/Reward → Trainer → BYO Model 部署 串成了一个闭环。
这可能比 Clef 本身更加值得关注。
0条留言